howto

Eigene CI für Radicle: vom Ref-Event zum überprüfbaren Release

Eine praktische Fortsetzung zum CI-Broker: eigene Radicle-Repositories bauen, Images und Helm-Charts veröffentlichen, mit Syft und Trivy prüfen und Releases mit überprüfbaren Digests beschreiben. Mit Konfigurationsbeispielen, den Gründen für cosign-legacy und den Grenzen des nativen Runners.

Wenn der erste Build durchläuft, funktioniert der grundlegende Ablauf einer eigenen CI. Für den verlässlichen Betrieb bleiben jedoch Fragen offen, die eine gehostete Forge oft bereits im Produkt beantwortet. Dazu gehören Ausführungsrechte, die Zuordnung von Images zu Commits und die Prüfung beider Architekturen. Dazu kommt die Freigabe eines Releases, bei der Git-Tag, Registry-Artefakt und Radicle-Veröffentlichung zusammenpassen müssen, obwohl sie getrennt entstehen.

Mein erster CI-Broker-Beitrag beschrieb die Probleme beim Aufbau und die Lösungen, die daraus entstanden sind. Diese Fortsetzung führt schrittweise durch die Einrichtung und richtet sich an Menschen, die Radicle bereits verwenden und ihre eigene CI betreiben möchten. Der Broker ist inzwischen bei v1.5.0 angekommen. Er unterstützt die gemeinsame Veröffentlichung und Signierung von Images und Charts, bringt Werkzeuge für SBOMs und Schwachstellenscans mit und verarbeitet Release-Ereignisse zuverlässiger.

Dafür muss niemand mein komplettes Lab nachbauen. Entscheidend ist der Weg vom replizierten Commit bis zu einem Artefakt, dessen Herkunft und Prüfergebnisse auch andere nachvollziehen können.
Paperless-ngx im Lab: vom Scan zum brauchbaren Archiv

Ein Dokumentenarchiv ist mehr als OCR hinter einer Weboberfläche. Wie ich Scanner, Mailimport, PostgreSQL, kontrollierte KI-Klassifikation und Off-site-Backups zusammenführe — und warum Eigentümer, Upload-Grenzen und Restore-Zeitpunkte dabei wichtiger sind als der Modellname.

Nach dem Scannen liegt die Rechnung als scan_0042.pdf in einem Verzeichnis. Sie lässt sich öffnen, aber ohne brauchbaren Namen und Metadaten später nur schwer wiederfinden. Bei E-Mails ist es ähnlich: Der Anhang ist vorhanden, sein Zusammenhang steckt jedoch im Postfach. Ob beides zuverlässig gesichert ist, muss zusätzlich geklärt werden.

Paperless-ngx soll in meinem Lab Dokumente aufnehmen, durchsuchbar machen und mit brauchbaren Metadaten versehen. Nach dem ersten erfolgreichen Upload ging es vor allem darum, den gesamten Ablauf verlässlich zu gestalten: Wie landet ein Scan vollständig im Archiv? Was darf ein Sprachmodell entscheiden? Und wie stelle ich Dateien und Datenbank so wieder her, dass sie zusammenpassen?

Tor als CRD: ein eigener Operator statt Sidecar-Bastelei

Warum ich den inoffiziellen tor-controller durch einen eigenen, in Rust geschriebenen Operator ersetzt habe — ein gemeinsamer Tor-Daemon pro Namespace, Onion-Services und Onion-Proxies dynamisch über den Control-Port, plus kuratierte obfs4-Bridges

Tor-Konnektivität im Cluster hatte ich bisher zusammengesteckt: pro Pod ein client-only tor plus ein oder zwei socat-Sidecars, die lokale TCP-Ports in Onion-Services übersetzten — genau das Setup, das ich im IRC-Bouncer-Beitrag beschrieben habe. Das funktioniert, skaliert aber nicht als Muster: Jeder Workload, der eine .onion erreichen oder selbst eine anbieten wollte, brachte seinen eigenen Tor-Prozess und seine eigene Klebeschicht mit. Also habe ich das Ganze zu dem gemacht, was es im Lab sein sollte: einer Custom Resource. tor-operator ist ein eigener, in Rust geschriebener Kubernetes-Operator, der Tor-Konnektivität in beide Richtungen als CRD anbietet.

Von Makefiles zu task: Das Cluster über Anweisungen bedienen

Warum ich die operativen Anweisungen meines Labs von Makefiles auf go-task migriert habe — mit Namespaces, Preconditions, Prompts und einem Überblick, was sich damit alles steuern lässt

Ein Follow-up zum GitOps-Aufbau meines Labs: Wenn das Repository den Zustand beschreibt, brauche ich trotzdem eine Handvoll Anweisungen, um den Cluster zu bedienen — bootstrappen, Secrets rotieren, Backups zurückspielen, Zertifikate erneuern. Lange lebten diese Anweisungen in Makefiles. Heute steckt jede davon in einem go-task -Taskfile, und der Umstieg war eine der besseren kleinen Entscheidungen.

WeeChat als IRC-Client: Nicht-Standard ~/.config/weechat

Wie ich WeeChat mit ZNC und dem Lab-IRC-Stack betreibe — Bars, Buffer, Trigger, Secrets und Scripts

Ich nutze WeeChat als IRC-Frontend im Zusammenspiel mit dem ZNC + InspIRCd-Setup im Lab.

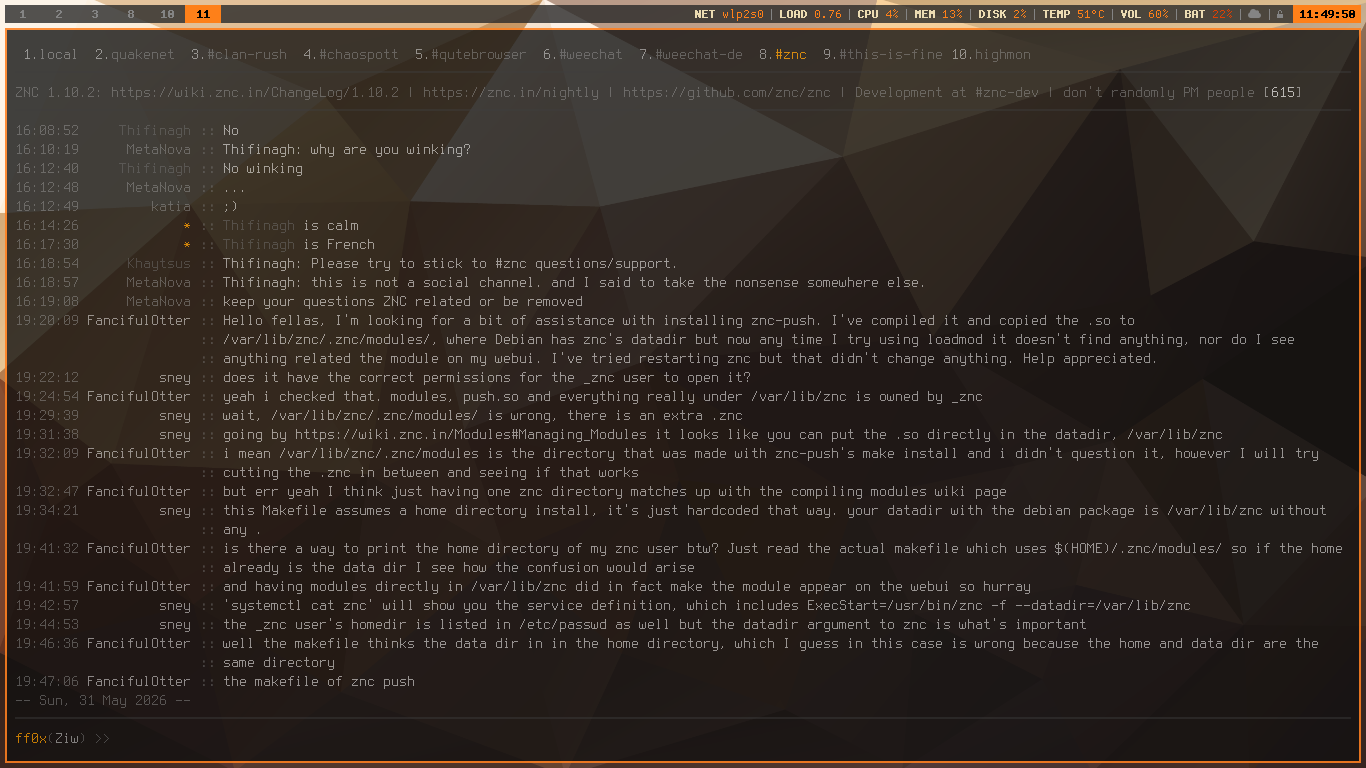
WeeChat im Lab — buflist links, grau/orange Transcript, Nicklist rechts, Tab **highmon**.

Setup#

Für die deklarative Konfiguration und den Rollout verwende ich Home-Manager — wie WeeChat dabei als reproduzierbares Nix-Artefakt entsteht und sich am Bouncer einklinkt, habe ich separat beschrieben . Hier geht es um die Konfiguration selbst. Mein Flake zur Verwaltung aller Systeme findest du hier ; einen ausführlicheren Blogpost dazu schreibe ich bei Gelegenheit.

Netzwerke und ZNC#

Vier IRC-Server stehen in irc.conf — drei laufen über den Bouncer, einer (Quakenet, mehr Gewohnheit als Vernunft) direkt:

  • libera, hackint und local — den cluster-internen IRCd — erreiche ich über den ZNC-Bouncer, der unter bnc.this-is-fine.social/+6697 via TLS hängt. Für ZNC aktiviere ich zusätzliche IRC-Capabilities (znc.in/server-time-iso, znc.in/self-message, …).
flowchart LR WC[WeeChat] ZNC[ZNC TLS SASL] LAB[bnc.this-is-fine.social] INSP[InspIRCd hydra] QN[irc.quakenet.org plain] WC --> ZNC WC --> LAB LAB --> INSP WC --> QN
Die Serverpasswörter liegen verschlüsselt in ${sec.data} und die Passphrase hierfür wird beim Startup von WeeChat über pass mit passphrase_command = "pass show apps/weechat/passphrase" entschlüsselt.

Layout: Bars und Buffer#

weechat.conf definiert ein eigenes Bar-Set — die Statuszeile unten ist absichtlich weg; Kontext steckt in der Title-Bar: